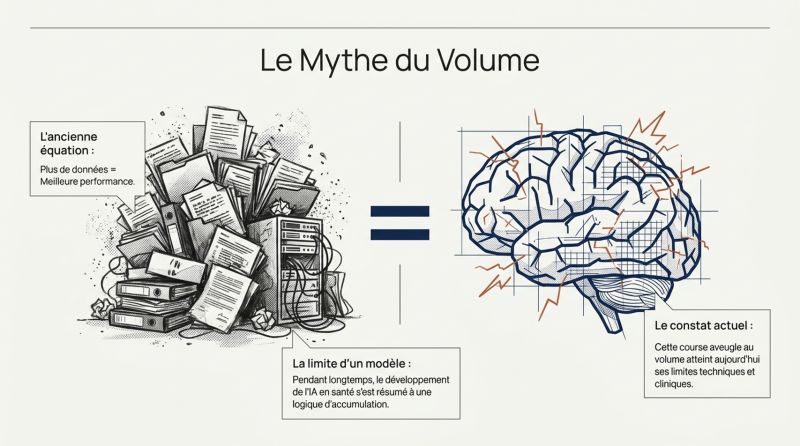
Pendant longtemps, le développement de l'IA en santé semblait suivre une règle simple : + de données = meilleure performance.
3 publications récentes invitent pourtant à revoir cette idée.
Dans une étude publiée dans npj Digital Medicine, des chercheurs ont démontré qu'un modèle de prédiction de maladies à partir des dossiers patients électroniques pouvait être transféré entre le Royaume-Uni, la Finlande et les États-Unis avec une performance supérieure lorsqu'il s'appuie sur les capacités sémantiques des grands modèles de langage (LLM).
Pourquoi ?
Parce que le modèle ne se contente plus de traiter des codes administratifs ou médicaux. Il comprend les relations de sens entre les concepts médicaux, ce qui lui permet de s'adapter à différents systèmes de codage et à différentes organisations des soins.
Une seconde étude, menée au UT MD ANDERSON CANCER CENTER, arrive à une conclusion complémentaire dans le domaine de l'imagerie.
Les chercheurs montrent que 244 examens soigneusement annotés par des experts peuvent produire des performances équivalentes à celles obtenues avec près de 3 000 examens de qualité plus variable.
Autrement dit :
Une donnée de meilleure qualité peut remplacer un volume considérable de données supplémentaires.
Mais l'étude montre aussi qu'un grand volume de données conserve un avantage lorsqu'il s'agit de généraliser les modèles à de nouveaux contextes cliniques.
Un troisième enseignement émerge autour des standards de données.
L'IA appliquée aux dossiers patients électroniques souffre encore d'un manque de standardisation.
C'est l'objectif du standard ouvert MEDS.
Conçu pour faciliter le développement et le partage d'algorithmes d'IA sur données de santé, MEDS est déjà utilisé dans 21 institutions, mobilisé dans au moins 27 publications scientifiques et prépublications, et supporte le développement de modèles de fondation appliqués aux dossiers patients électroniques.
Les résultats sont impressionnants :
• jusqu'à 70 % de réduction du code pour développer certaines applications ;
• accélérations de calcul pouvant atteindre plusieurs milliers de fois selon les usages ;
• amélioration de la reproductibilité et de la transférabilité des modèles.
Ces trois travaux convergent vers une même conclusion.
L'avenir de l'IA en santé ne reposera pas uniquement sur l'accumulation de données.
Il reposera sur trois piliers :
• des données de qualité ;
• des représentations sémantiques capables de comprendre le sens clinique ;
• des standards ouverts permettant de partager, reproduire et déployer les innovations à grande échelle.
La question n'est donc plus seulement : « Avons-nous suffisamment de données ? »
Mais plutôt : « Nos données sont-elles suffisamment compréhensibles, réutilisables et interopérables pour produire une IA généralisable ? »
Sources:
Kirchler, M., Ferro, M., Lorenzini, V. et al. Large language models improve transferability of electronic health record-based predictions across countries and coding systems. npj Digit. Med. 9, 177 (2026). https://doi.org/10.1038/s41746-026-02363-5
Matthew B. A. McDermott, Ph.D, Ethan Steinberg, Ph.D., Jason A. Fries, Ph.D. , Robin P. van de Water, M.S. , Chao Pang, Ph.D. , Patrick Rockenschaub, Ph.D., Pawel Renc, Ph.D. , and Nigam H. Shah, Ph.D., M.B.B.S. MEDS — An Emerging Data Standard and Ecosystem for Health AI Research, https://ai.nejm.org/doi/full/10.1056/AIra2501253