C'est l'un des arguments les plus souvent avancés lorsqu'on parle d'IA en santé.
Pourtant, la littérature scientifique raconte une autre histoire.
Les patients ne refusent pas de partager leurs données. Ils refusent de les partager sans garanties.
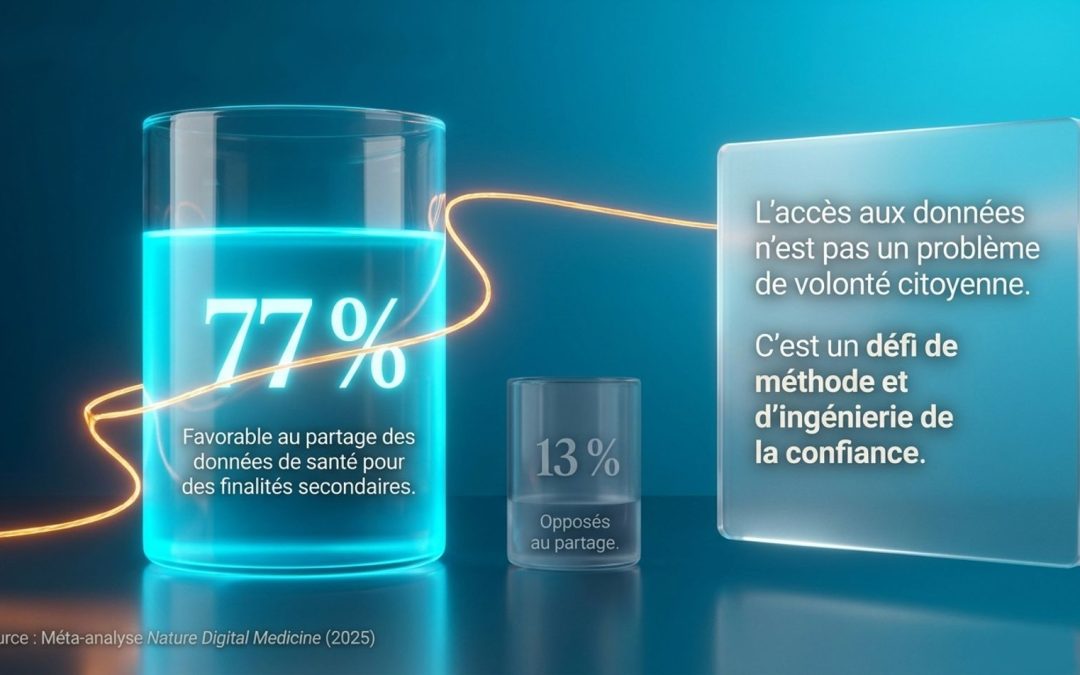
Une méta-analyse publiée dans Nature Digital Medicine (2025) montre que 77 % des personnes sont prêtes à partager leurs données de santé pour la recherche ou l'amélioration des soins. L'opposition existe, mais elle reste minoritaire (13 %).
Une étude publiée en 2026 confirme que l'acceptabilité dépend moins de la technologie que de la confiance accordée aux organisations qui utilisent les données. Les patients déjà confrontés à la maladie sont largement favorables au partage lorsqu'ils perçoivent un bénéfice collectif pour la recherche.
Ce qui fait réellement basculer la confiance
Les patients acceptent plus volontiers de partager leurs données lorsque :
✅ la finalité est clairement expliquée ;
✅ les mesures de sécurité sont explicites ;
✅ ils savent qui accède aux données et pourquoi ;
✅ le médecin ou l'équipe soignante reste un intermédiaire de confiance.
Comment lever les freins au partage des données ?
La confiance n'est pas un facteur immuable. Il existe plusieurs leviers concrets pour favoriser l'adhésion des patients.
Renforcer la relation médecin-patient
La confiance dans le système de santé demeure le principal déterminant du consentement au partage des données. Les patients sont davantage disposés à accepter l'utilisation de leurs données lorsqu'ils comprennent l'objectif poursuivi et lorsque l'information est relayée par des professionnels de santé de confiance.
Clarifier le consentement grâce à l'IA
Les formulaires de consentement sont souvent longs, complexes et peu lus. Les modèles de langage peuvent aider à transformer ces documents en explications plus simples, personnalisées et interactives afin de les rendre réellement compréhensibles.
Développer l'usage des données synthétiques
Une autre voie prometteuse consiste à utiliser des données synthétiques pour la recherche et l'entraînement des modèles. Générées à partir de données réelles mais ne correspondant à aucun individu existant, elles permettent de préserver la confidentialité tout en conservant une grande partie de la valeur scientifique des jeux de données.
Le véritable défi n'est pas de convaincre les patients de partager leurs données.
Le défi est de construire une gouvernance digne de leur confiance.
Sources:
Borsukiewicz, P., Boutros, F., Olatunji, I.E. et al. Beyond real faces: synthetic datasets can achieve reliable recognition performance without privacy compromise. npj Artif. Intell. (2026). https://doi.org/10.1038/s44387-026-00115-0
Grimaldi, L., Bovi, E., Tagliente, S. et al. Patients and donors trust in data authorization for AI-based medical research. Sci Rep 16, 20652 (2026). https://doi.org/10.1038/s41598-026-51247-x
Olsen, Q., Dyda, A., Woods, L. et al. Worldwide willingness to share health data high but privacy, consent and transparency paramount, a meta-analysis. npj Digit. Med. 8, 540 (2025). https://doi.org/10.1038/s41746-025-01868-9
Rishabh Goel, B.A., B.S. , Sammy Mustafa, M.S. , Trevor J. Baker, M.S. , and Barbara E. Bierer, M.D, Large Language Models in Informed Consent — Opportunities, Evidence, and Challenges, NEJM AI 2026;3(6), DOI: 10.1056/AIra2600073